AI 智算基础设施
面向大模型训练、AI 推理、科研计算、政企智算中心建设,提供异构算力、高速网络、分布式存储、算力调度、液冷散热一体化智算底座,满足高性能、高可靠、绿色节能、弹性扩展需求,支撑企业 AI 业务快速落地。
Related Products
方案相关产品
Pain Point Analysis
您是否也面临这些困境?
深入了解企业在AI 智算基础设施领域的核心挑战,找到真正适合您的解决之道
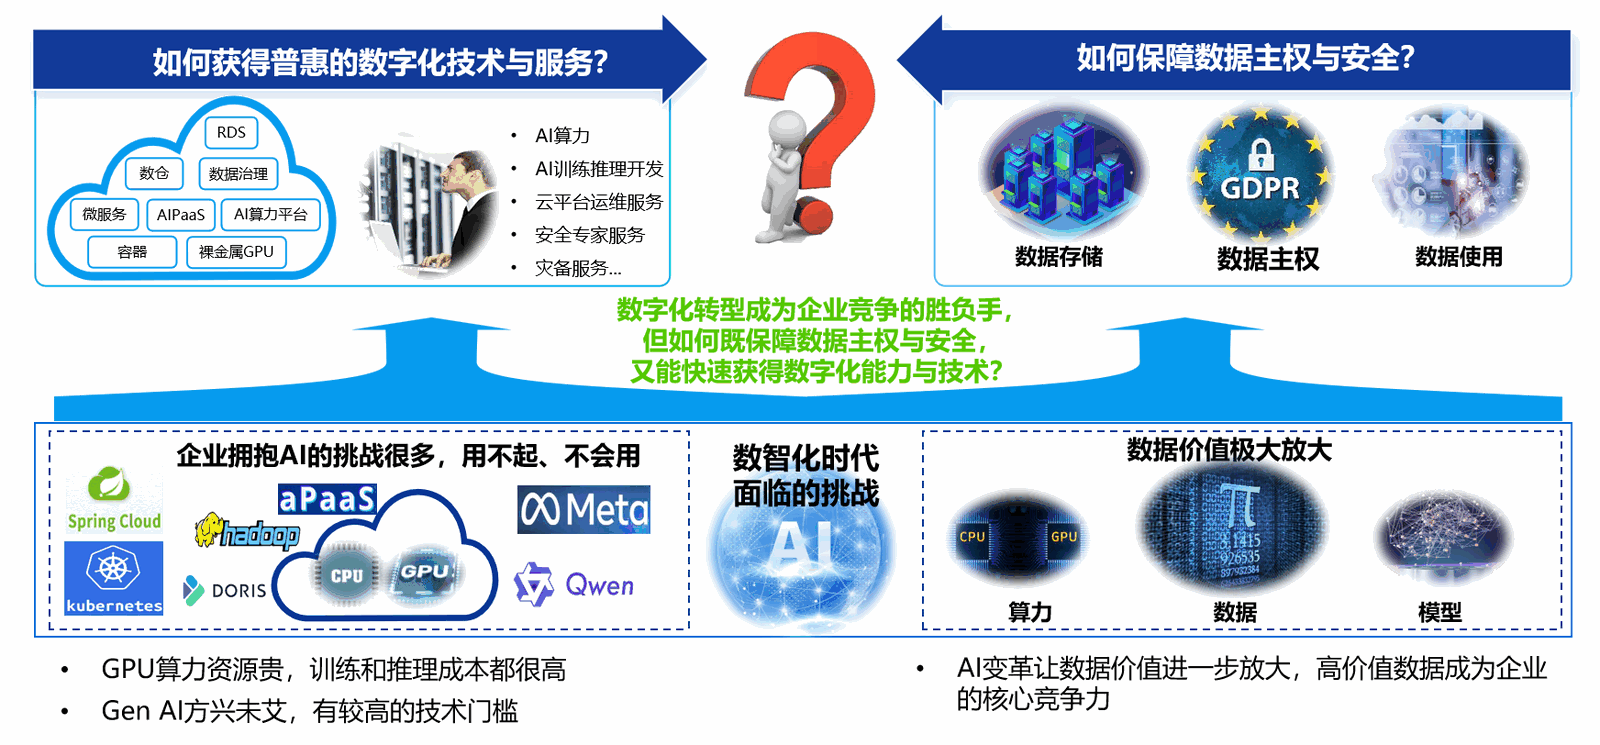
算力不足,AI 训练效率低
传统服务器算力弱,无法支撑大模型、高并发训练,训练周期长、成本高。
网络瓶颈,多卡协同慢
普通网络带宽低、时延高,多显卡卡/多服务器通信效率差,影响模型收敛速度。
存储性能不足,数据读写卡顿
AI海量小文件与高并发读写导致存储瓶颈,拖慢整体训练效率。
散热压力大,能耗成本高
高密算力设备发热大,传统风冷难以散热,PUE 高、运营成本高。
算力分散,管理复杂
算力资源孤立、调度困难,利用率低,无法统一管理与弹性分配。
Solution Brief
方案简介
随着 AI 大模型、深度学习、行业智能化快速发展,传统 IT 架构无法满足高算力、高吞吐、低时延、高密度散热的需求。AI 智算基础设施解决方案以GPU算力为核心,融合高速无损网络、并行文件存储、统一算力平台、液冷节能技术,构建全栈式智算中心底座。支持千卡级集群扩展、大模型训练/推理全流程、算力弹性调度、数据安全可靠,适用于企业自建智算中心、科研计算、自动驾驶、医疗影像、智能制造等场景,帮助企业快速构建安全、高效、绿色的 AI 算力平台。
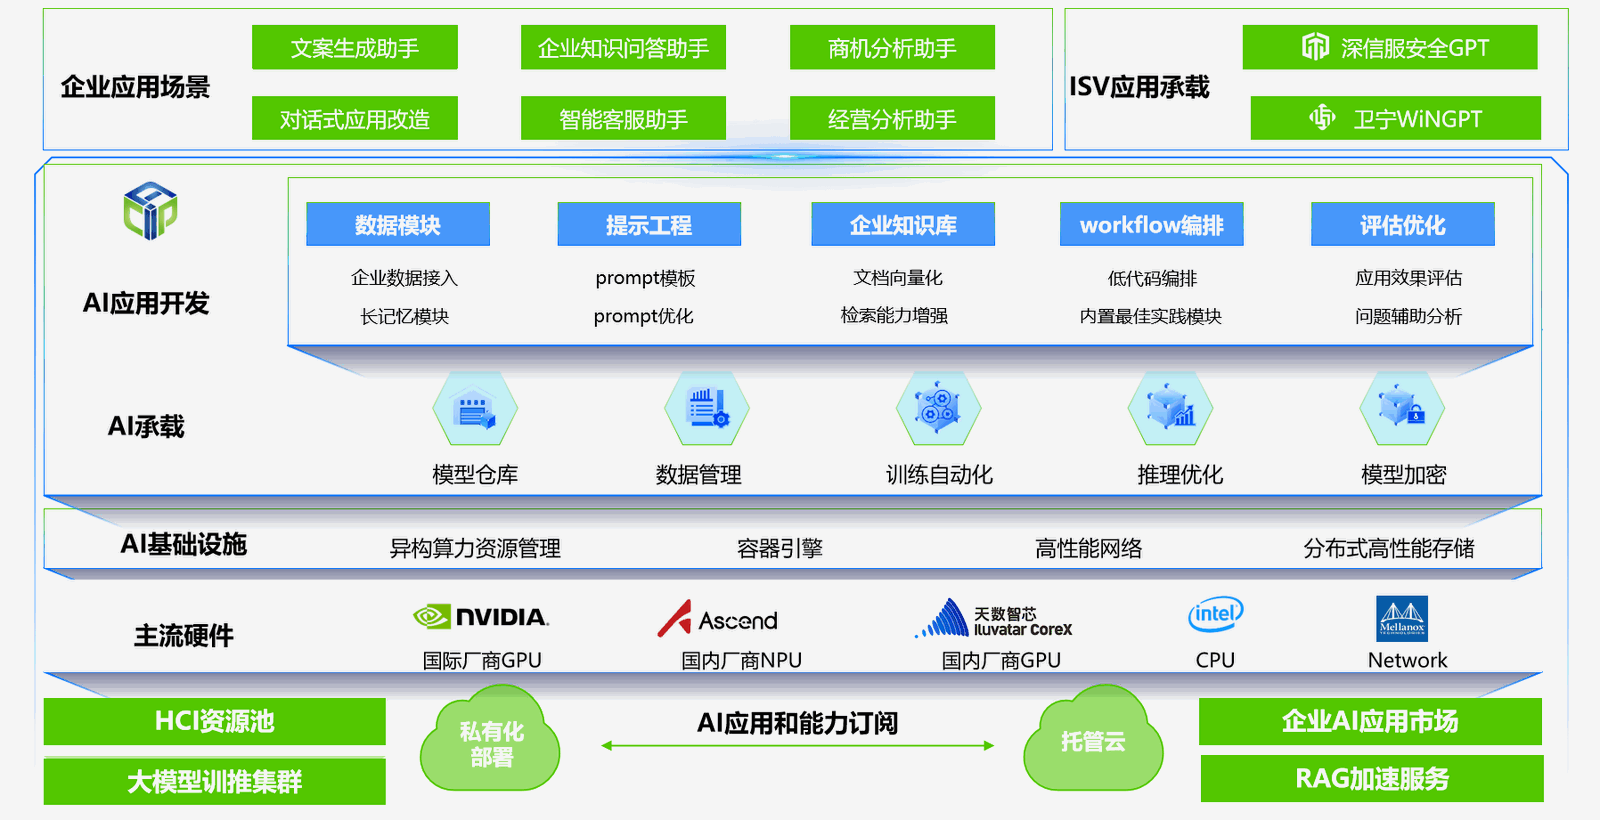
算力集群
支持GPU多元算力,统一纳管、按需分配,满足训练与推理不同需求。
高速无损网络
低时延网络,提升多机多卡通信效率,加速模型训练。
分布式并行存储
高吞吐、高 IOPS 存储架构,支撑 AI 海量数据快速读写,不拖后腿。
液冷高效散热
冷板 / 浸没式液冷,支持高密算力部署,显著降低能耗与 PUE。
统一算力平台
算力调度、任务管理、监控告警、运维可视化,提升资源利用率。
高可靠与安全
权限审计、模型加密,保障业务稳定与数据安全。
方案价值总结
选择我们的AI 智算基础设施,获得可量化的业务价值提升
算力性能大幅提升
千卡级线性扩展,低时延高带宽,显著缩短训练周期,提升AI研发效率。
绿色节能降本
液冷+智能供电,降低能耗与机房成本,长期TCO更优。
资源利用率提升
算力统一调度、弹性分配,避免资源浪费,提高整体使用效率。
业务快速落地
一体化交付、快速上线,缩短智算中心建设周期,加速 AI 应用落地。
安全合规可控
支持国产化适配、数据安全、等保合规,满足政企核心场景要求。